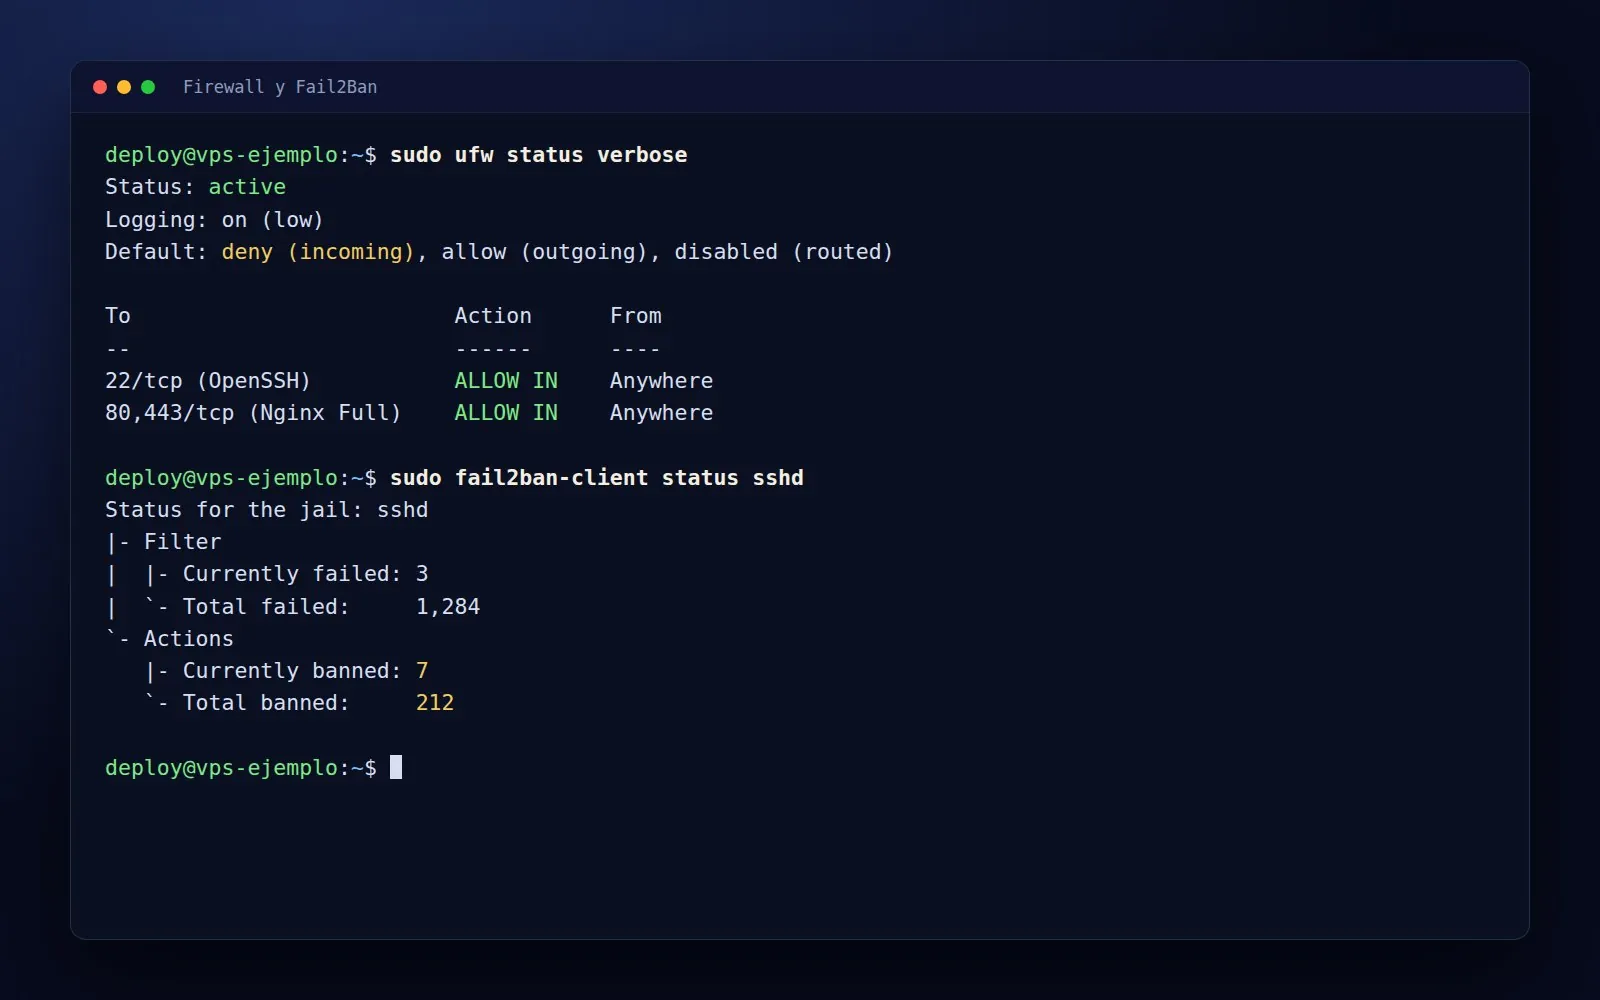
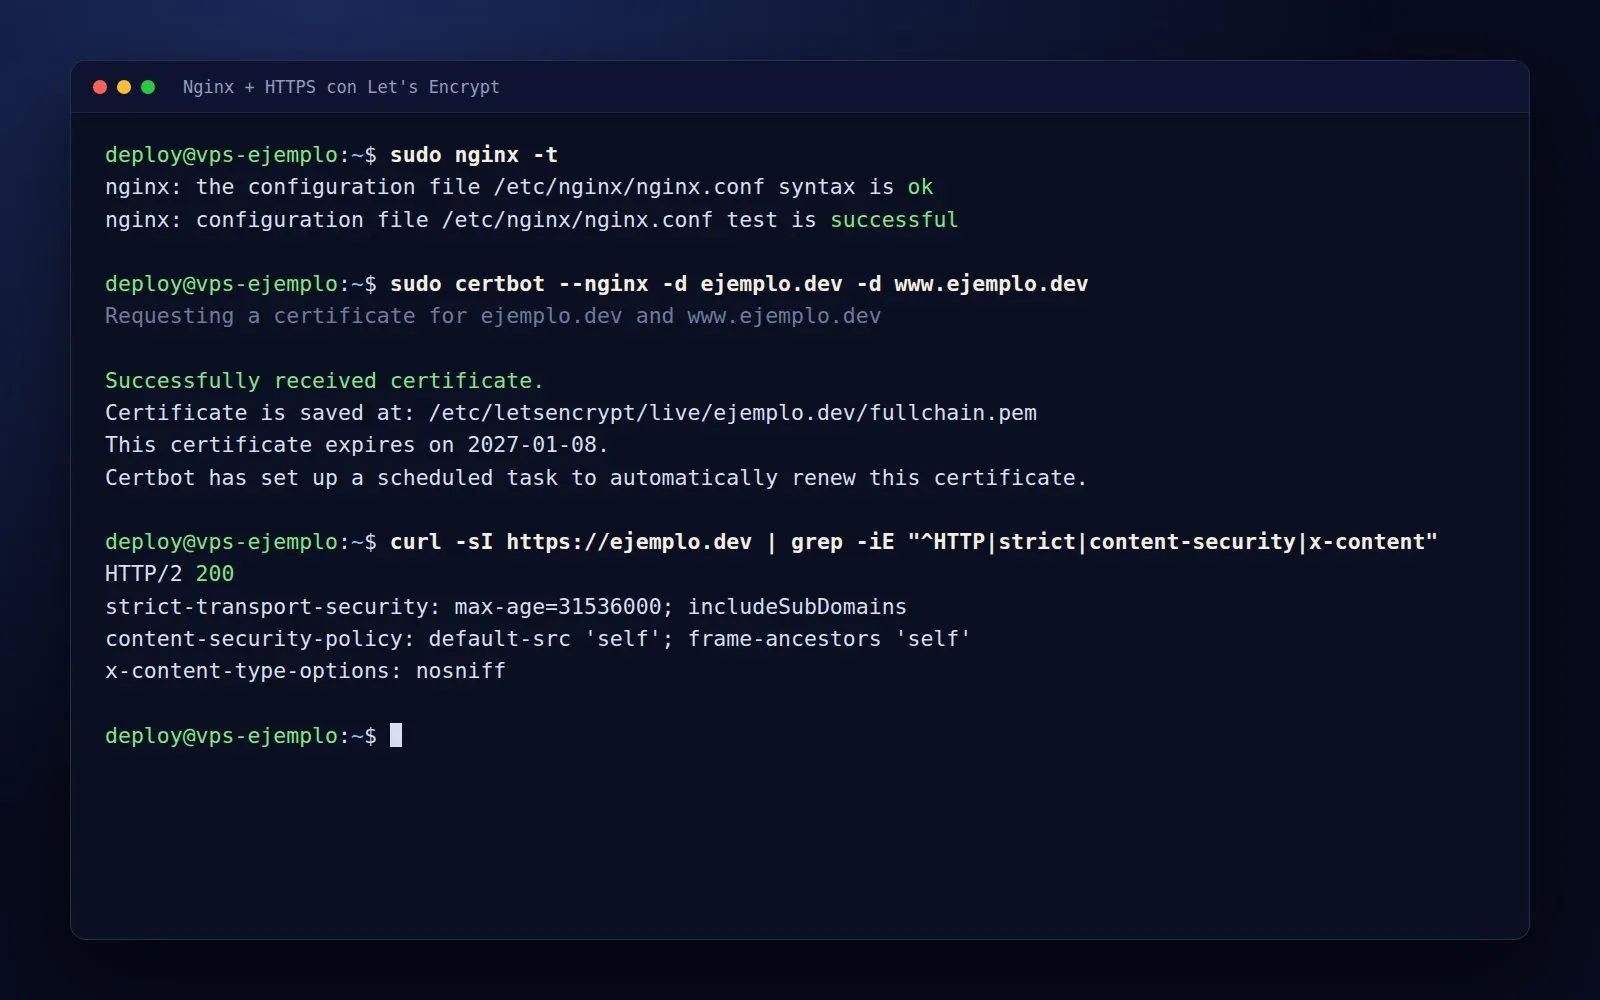
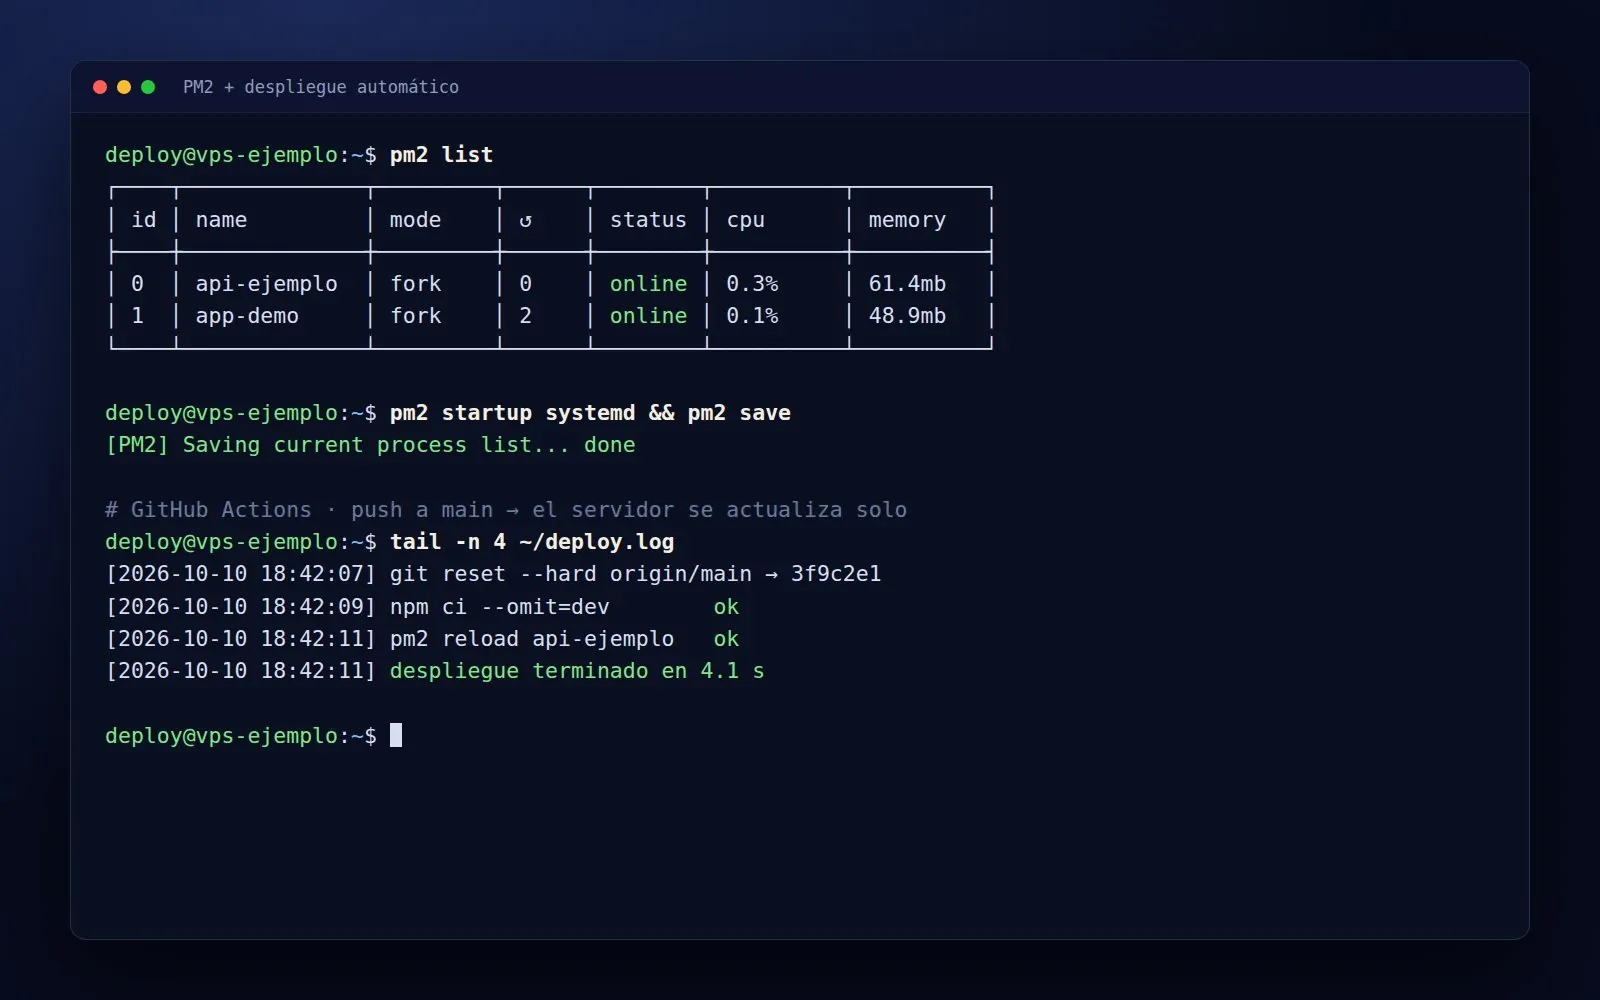
Código destacado
Primero el sistema original (dataset, entrenamiento en GPU, FedAvg,
backend y frontend) y al final la versión ligera que corre aquí.
El retoversión originalNo existía un dataset del
abecedario de LSM como lo necesitábamos. Teníamos que grabarlo nosotros mismos:
miles de imágenes por letra, de cinco personas distintas, sin que fuera un martirio.
Cómo lo resolvíUna pantalla de captura en Next.js: eliges la letra, haces la
seña y la app toma ~6 fotos por segundo, ya en espejo y recortadas,
con un contador hacia la meta de 200 por letra. Así juntamos 55,974
imágenes; después un proceso en Python les extraía los puntos de la
mano y las secuencias de movimiento.
El retoversión originalLas letras que se trazan
en el aire (J, Z, RR, LL, X, Ñ, K, Q) no caben en una foto. El modelo tenía que leer
una secuencia y entender el orden de los movimientos.
Cómo lo resolvíDiseñé un Transformer que recibe 20 cuadros
seguidos de puntos de la mano. La codificación posicional le da el orden; la
atención (8 cabezas) compara cada cuadro con los demás, así distingue una I quieta
de una J que se curva. Con esta misma clase entrenamos el modelo de todas las letras
y uno especializado en movimiento, que fue el que mejor reconoció
las letras en movimiento.
El retoversión originalEntrenar con decenas de
miles de imágenes en el procesador tardaba horas. Necesitábamos la tarjeta NVIDIA de
la computadora y ver el avance en vivo, no esperar a ciegas a que terminara.
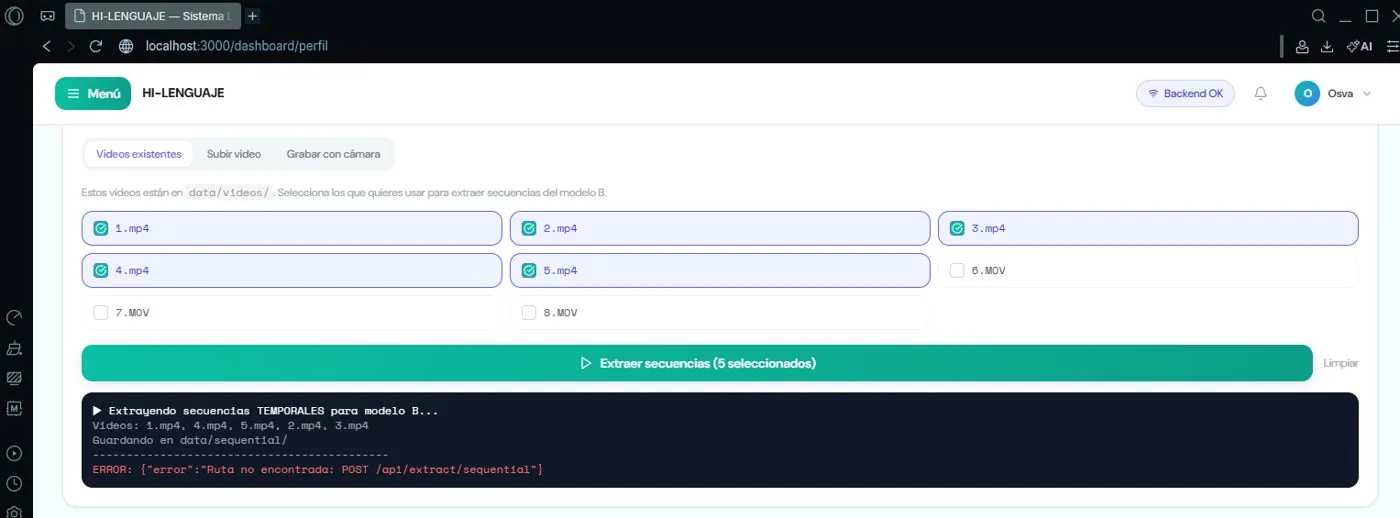
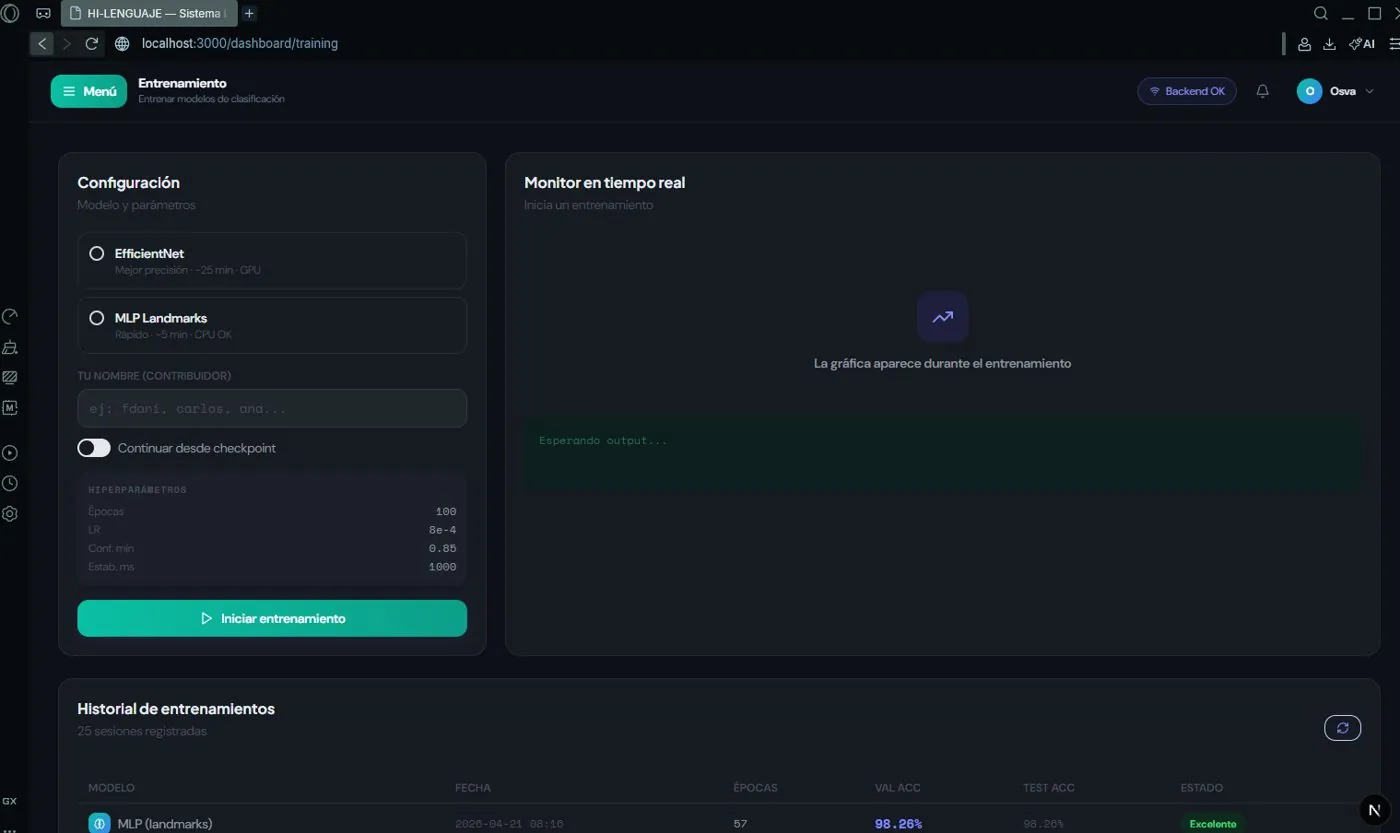
Cómo lo resolvíEn el panel elegías el modelo, el dataset y el
dispositivo: GPU con CUDA (la tarjeta NVIDIA), CPU o automático.
PyTorch movía el modelo y cada lote de datos a la GPU, que hace miles de
multiplicaciones en paralelo. Cada época, Python mandaba una línea por
Server-Sent Events y el frontend la convertía en puntos de la
gráfica de pérdida y precisión, avisando cuando se guardaba un
nuevo mejor modelo. También se podía reanudar un entrenamiento en
lugar de empezar de cero.
El retoversión originalCinco personas podían
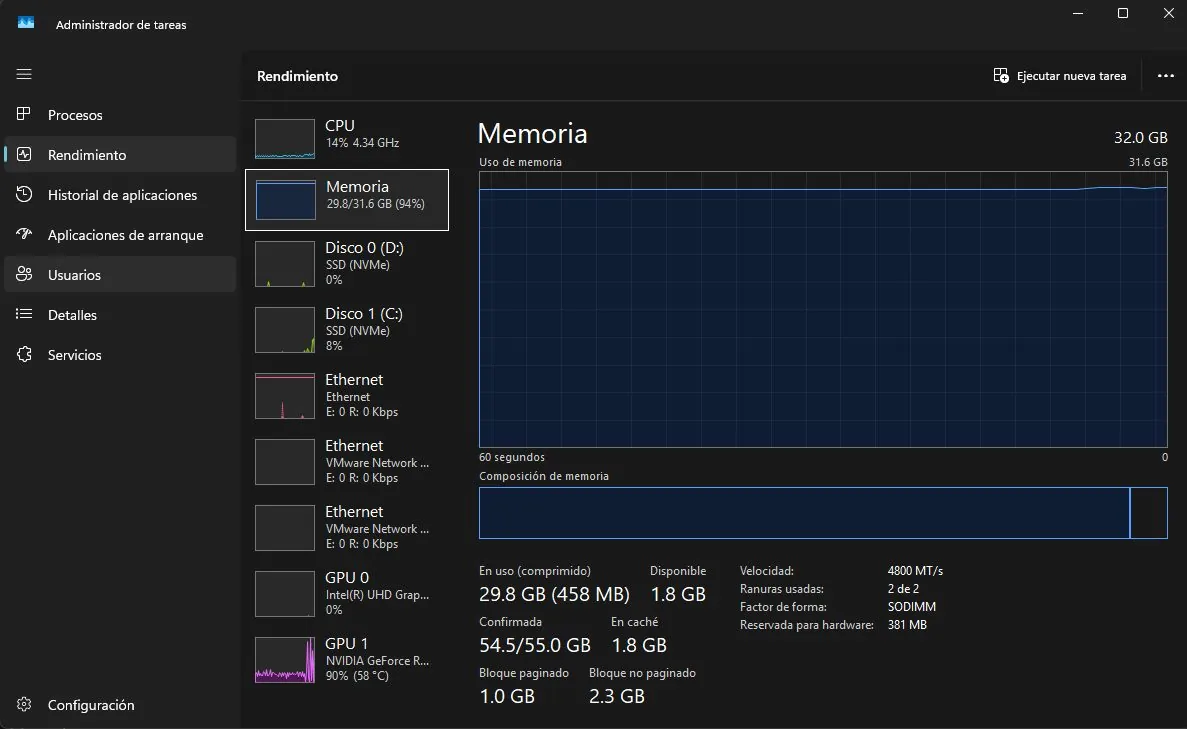
lanzar entrenamientos desde la plataforma, pero la máquina ya andaba al límite de
RAM y GPU. Además cada modelo tenía que quedar registrado a nombre de quien lo
entrenó, para luego combinarlos con FedAvg.
Cómo lo resolvíEl backend en Node revisa el token, aplica un límite de
5 entrenamientos por hora y toma el nombre del integrante del
token, no del formulario. Python entrenaba y mandaba el progreso
(pérdida, precisión, época) en vivo por Server-Sent Events para las
gráficas del panel; al final, FedAvg promediaba los pesos de cada quien en un modelo
global.
El retoversión originalCada integrante entrenaba
con sus propias grabaciones en su computadora. Teníamos cinco modelos distintos y
queríamos uno solo que supiera lo de todos, sin juntar todos los videos en un mismo
lugar.
Cómo lo resolvíUsamos aprendizaje federado (FedAvg). Cada
modelo entrenado se guardaba como “contribución” con el nombre de quien lo hizo
(sacado del token). Desde el panel, un admin lanzaba la fusión: Python cargaba los
pesos de todas las contribuciones del mismo tipo, promediaba capa por
capa y validaba el resultado. Así salió el modelo global (EfficientNet
FedAvg), que aparece marcado como “FedAvg” al elegir modelo en la inferencia.
El retoversión originalEl frontend no debía
hablar directo con el servidor de IA: había que poner en medio login, límites,
registro de peticiones y una sola dirección pública para todo.
Cómo lo resolvíUn API en Express que concentra todo: CORS
solo para nuestro frontend, JWT, rate limiting,
multer para recibir videos y fotos, axios para
reenviar a Python (FastAPI) y el relay de WebSockets. Si Python se cae, Node
responde con un error claro (502) en lugar de dejar al frontend colgado.
El retoversión originalEn la versión completa, el
frontend tenía que mandar los cuadros al servidor de IA en Python, pero sin exponer
esa dirección ni dejarlo abierto a cualquiera.
Cómo lo resolvíUn backend en Node.js hacía de intermediario:
login con JWT, límites de peticiones y un relay de WebSockets en tiempo real entre
el navegador y el servidor Python (FastAPI + PyTorch). Ese sistema completo también
tenía captura del dataset, entrenamiento con gráficas y aprendizaje federado
(FedAvg): cada integrante entrenaba con sus datos y luego se
promediaban los pesos en un modelo global.
El retoversión originalEn la plataforma completa
la IA vivía en el servidor con la GPU. El navegador tenía que mandarle video sin
parar y recibir la letra al instante, y además poder cambiar la velocidad o la
seguridad sin cortar la conexión.
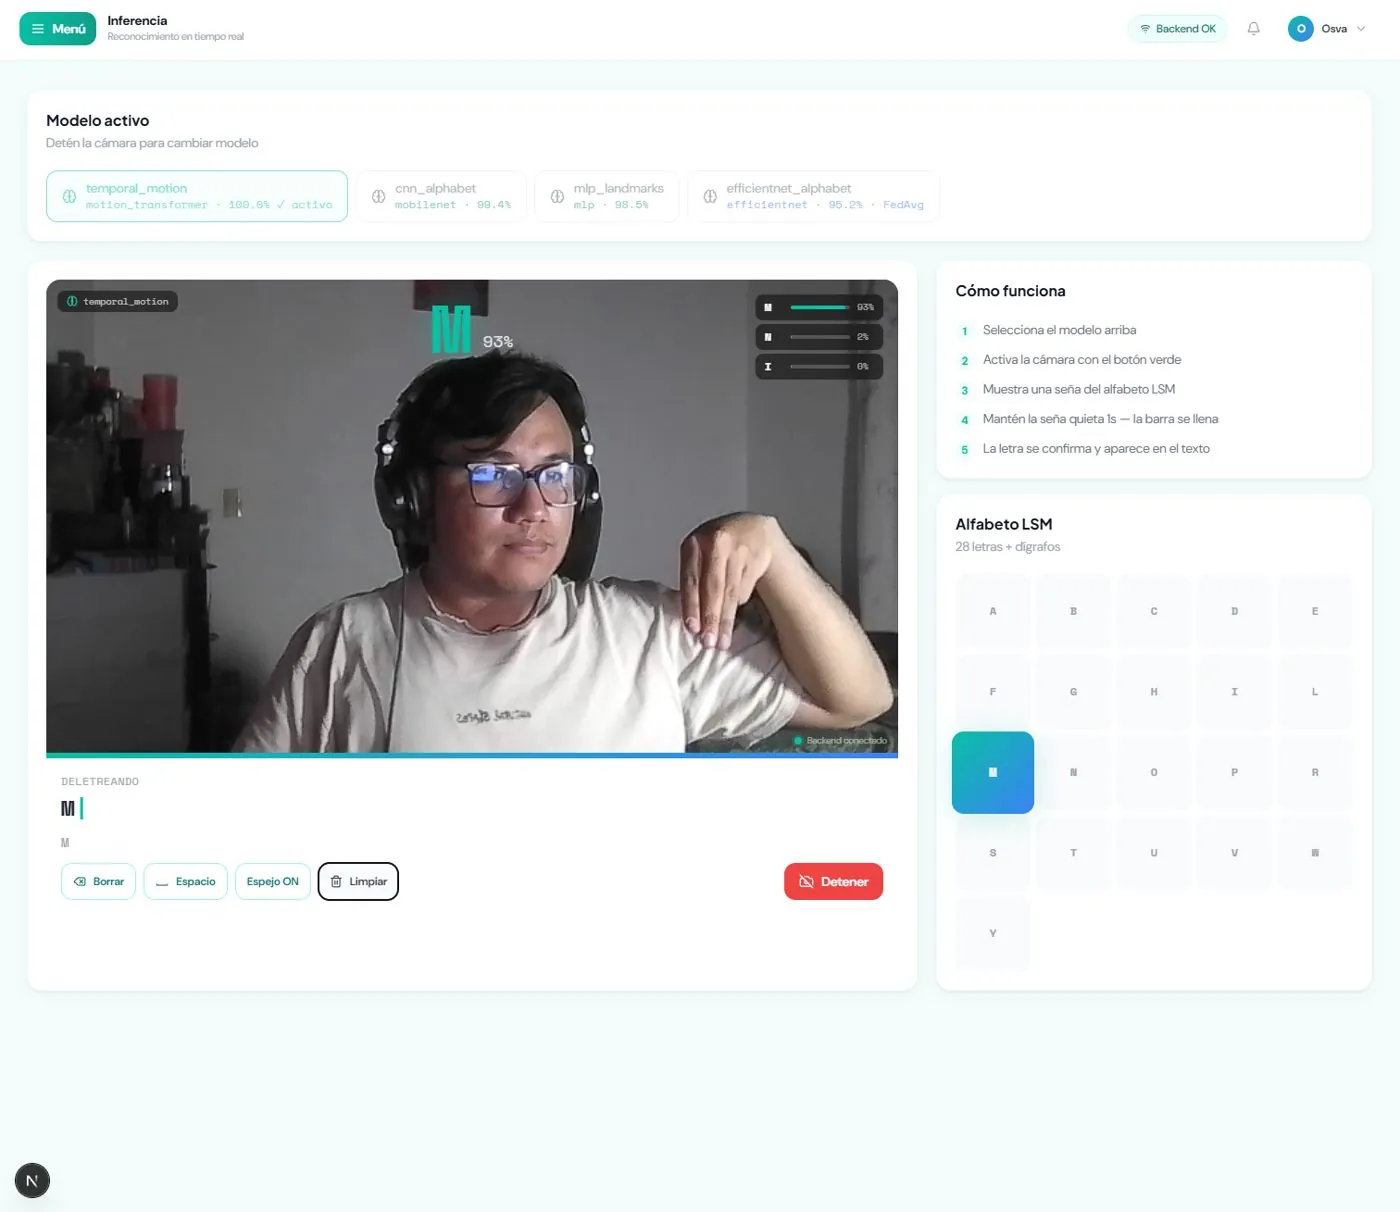
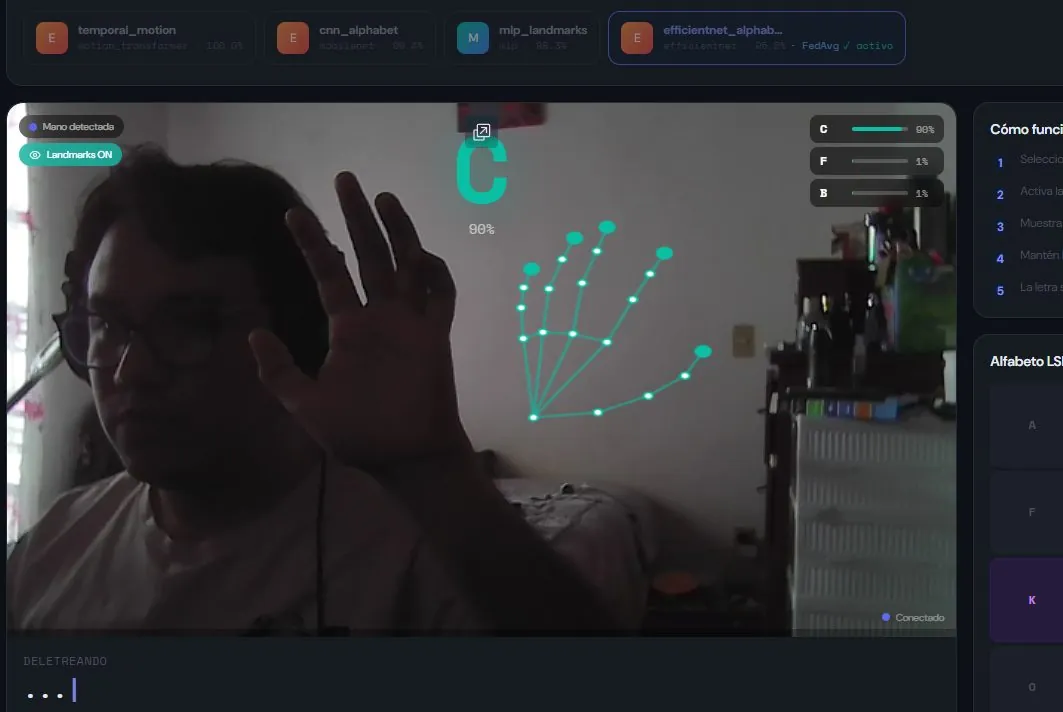
Cómo lo resolvíLa cámara se reduce a 320×240 y se manda como JPEG 10
veces por segundo por WebSocket; el servidor responde la letra, su
seguridad, el top 3 y los puntos de la mano para dibujarlos. Los ajustes viajan como
mensajes config por el mismo canal, y se podía elegir qué modelo usar,
incluido el combinado por FedAvg.
El retoversión ligeraLa primera versión
necesitaba un servidor Python con los modelos completos: pesada y cara de mantener
en línea. Queríamos que cualquiera la probara desde su celular.
Cómo lo resolvíExporté los tres modelos de PyTorch a ONNX y
los cuantizé a 8 bits: entre los tres pesan unos 4 MB. En el
navegador corren con ONNX Runtime en WebAssembly, junto con MediaPipe. Resultado: el
servidor solo entrega archivos, todo el cálculo pasa en el dispositivo y el
video nunca sale de él.
El retoversión ligeraHacer que el
navegador, sin servidor de IA, cargara tres redes neuronales y el detector de manos
de Google, pidiera permiso de cámara y procesara cada cuadro sin trabarse.
Cómo lo resolvíONNX Runtime Web corre los modelos en
WebAssembly y MediaPipe Hands encuentra la mano; todo se sirve
desde nuestro propio servidor (carpeta vendor/), sin depender de CDNs.
La cámara se pide con getUserMedia y, si la niegan, se explica cómo
permitirla. El ciclo con requestAnimationFrame y una bandera
busy procesa un cuadro a la vez, para que un celular lento no se
sature.
El retoversión ligeraLa cámara da video,
pero un modelo necesita números. Y tenían que ser exactamente los mismos números con
los que entrenamos en Python, o el modelo se confunde.
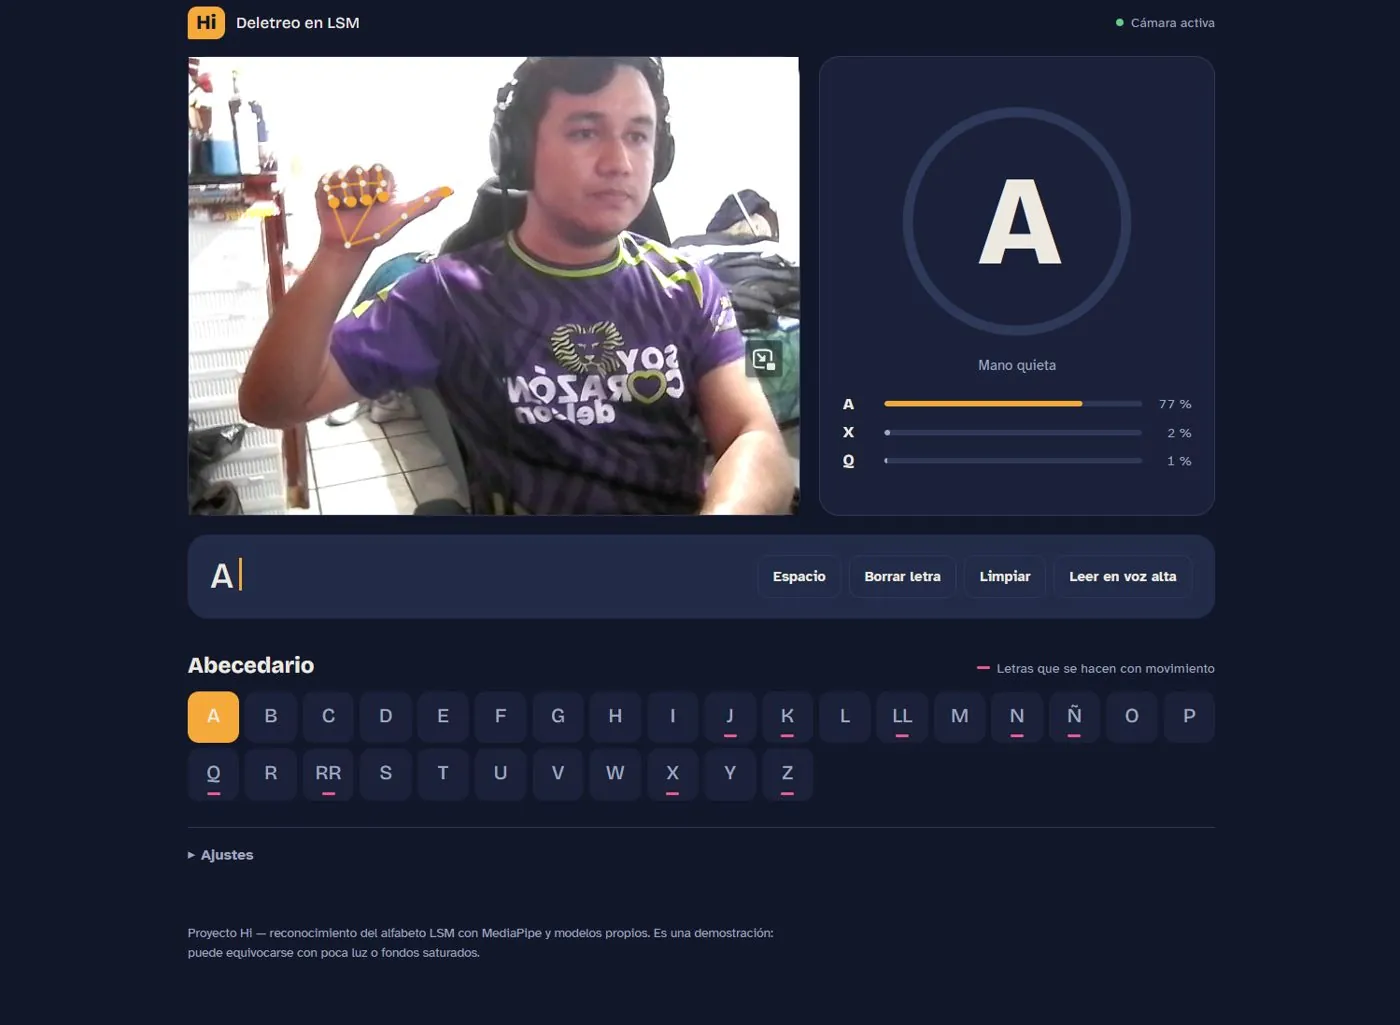
Cómo lo resolvíCada cuadro se convierte en 63 números: la posición de los 21
puntos relativa a la muñeca y normalizada. Así da
igual si la mano está cerca o lejos de la cámara, o en qué parte de la imagen. Esta
función replica línea por línea la de Python, para que el modelo vea en el navegador
lo mismo que vio al entrenar.
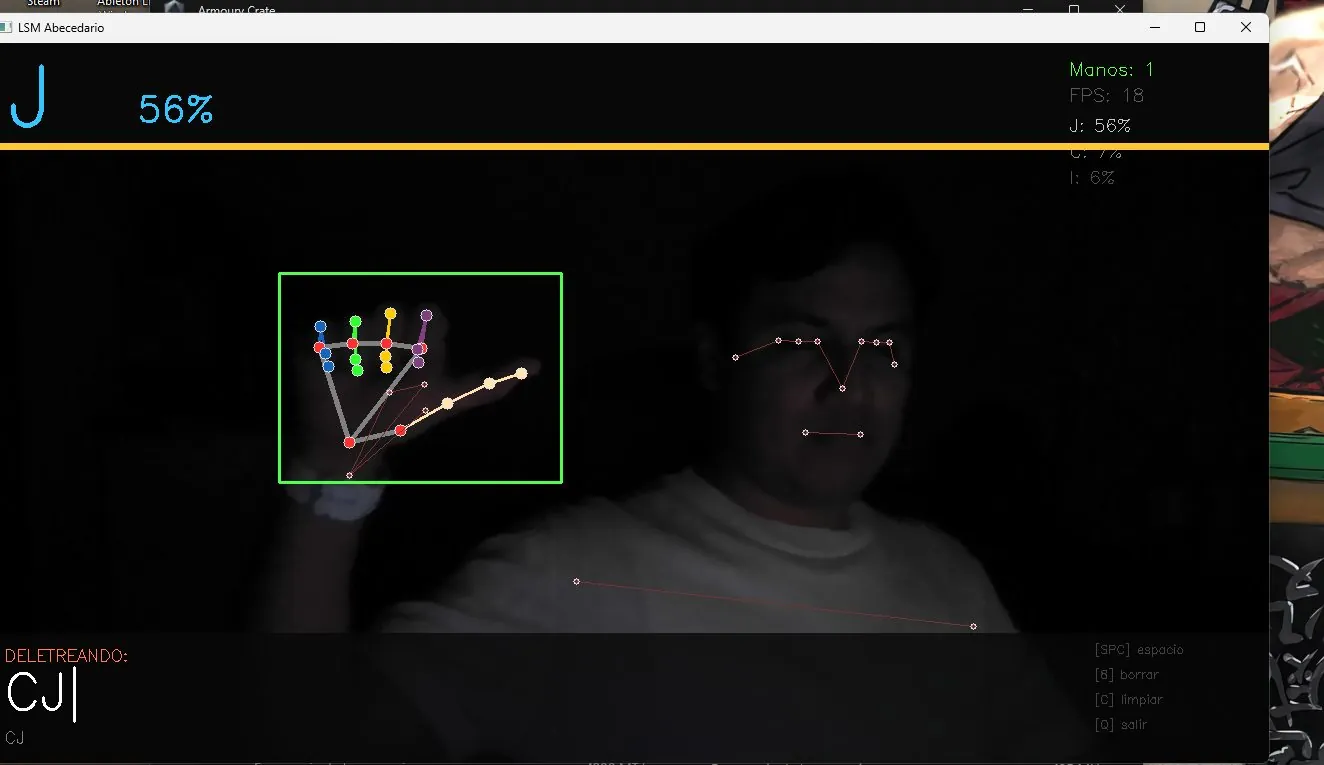
El retoversión ligeraHay letras que se
hacen con la mano quieta y otras con movimiento (J, Z, RR, LL…). Un solo modelo no
hacía bien las dos cosas.
Cómo lo resolvíDiseñé un sistema de tres modelos: un MLP
rápido para las 21 letras quietas, un Transformer que mira los últimos 20 cuadros
para las 29 letras, y otro Transformer especializado en las 8 letras con movimiento.
El código mide cuánto se mueve la mano y mezcla sus respuestas: con
la mano quieta manda el MLP; en cuanto se mueve, toman el control los Transformers.
El retoversión ligeraEl modelo cambia de
opinión varias veces por segundo. Si se escribiera cada respuesta, saldría basura en
pantalla.
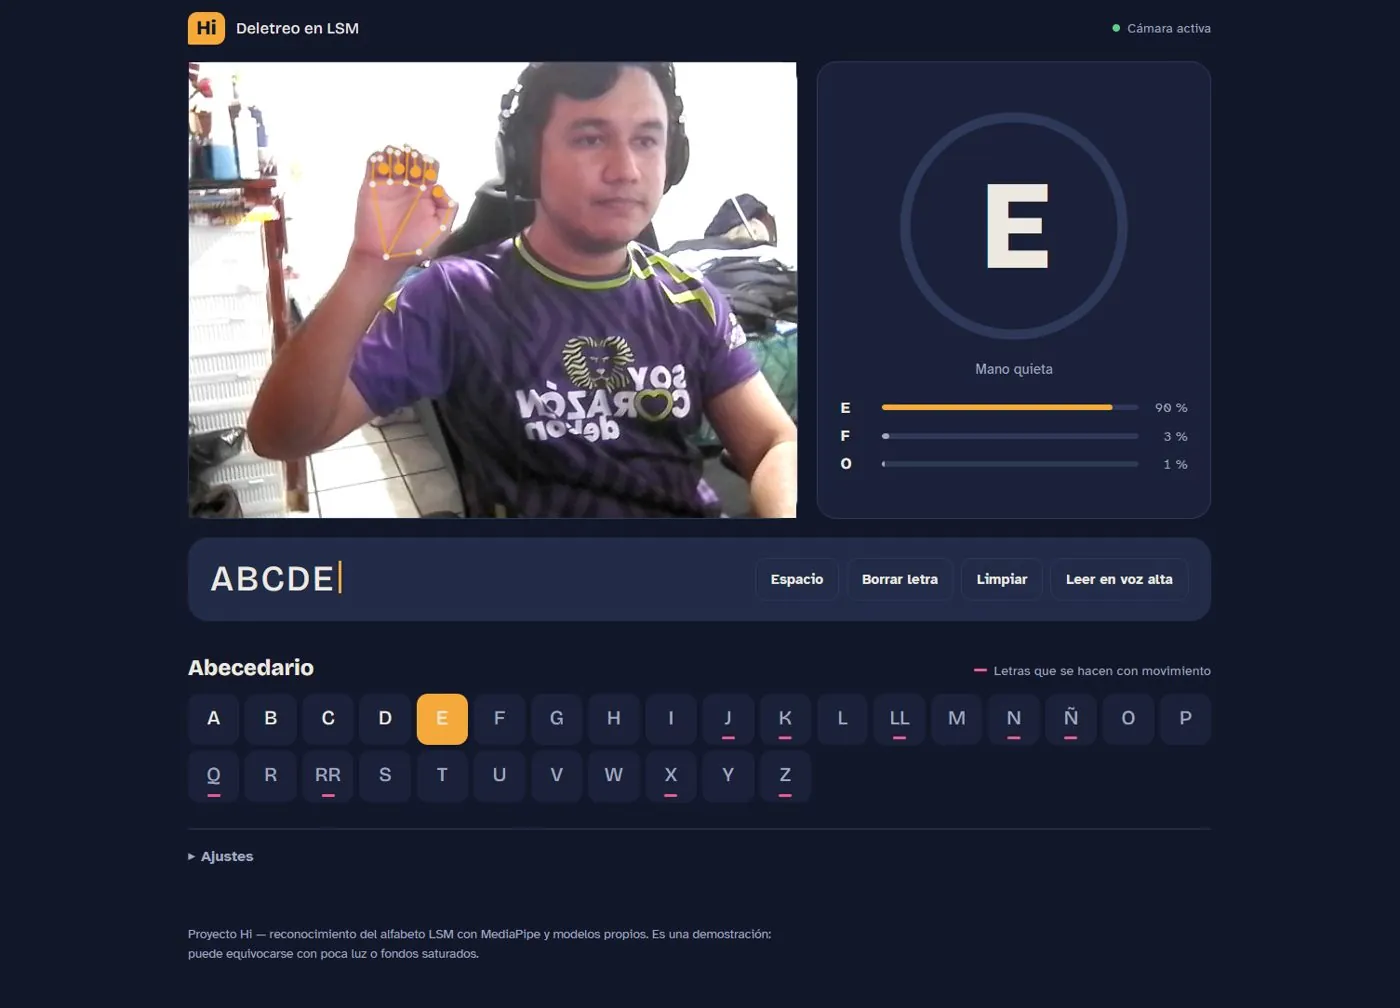
Cómo lo resolvíPrimero se suavizan las probabilidades entre
cuadros. Luego una letra solo se escribe si supera la seguridad mínima (60 %) y se
sostiene 0.8 s; el anillo alrededor de la letra se va llenando para
que la persona vea el avance. Al retirar la mano se agrega un espacio, y el texto se
puede leer en voz alta.
 00
Captura aquí